

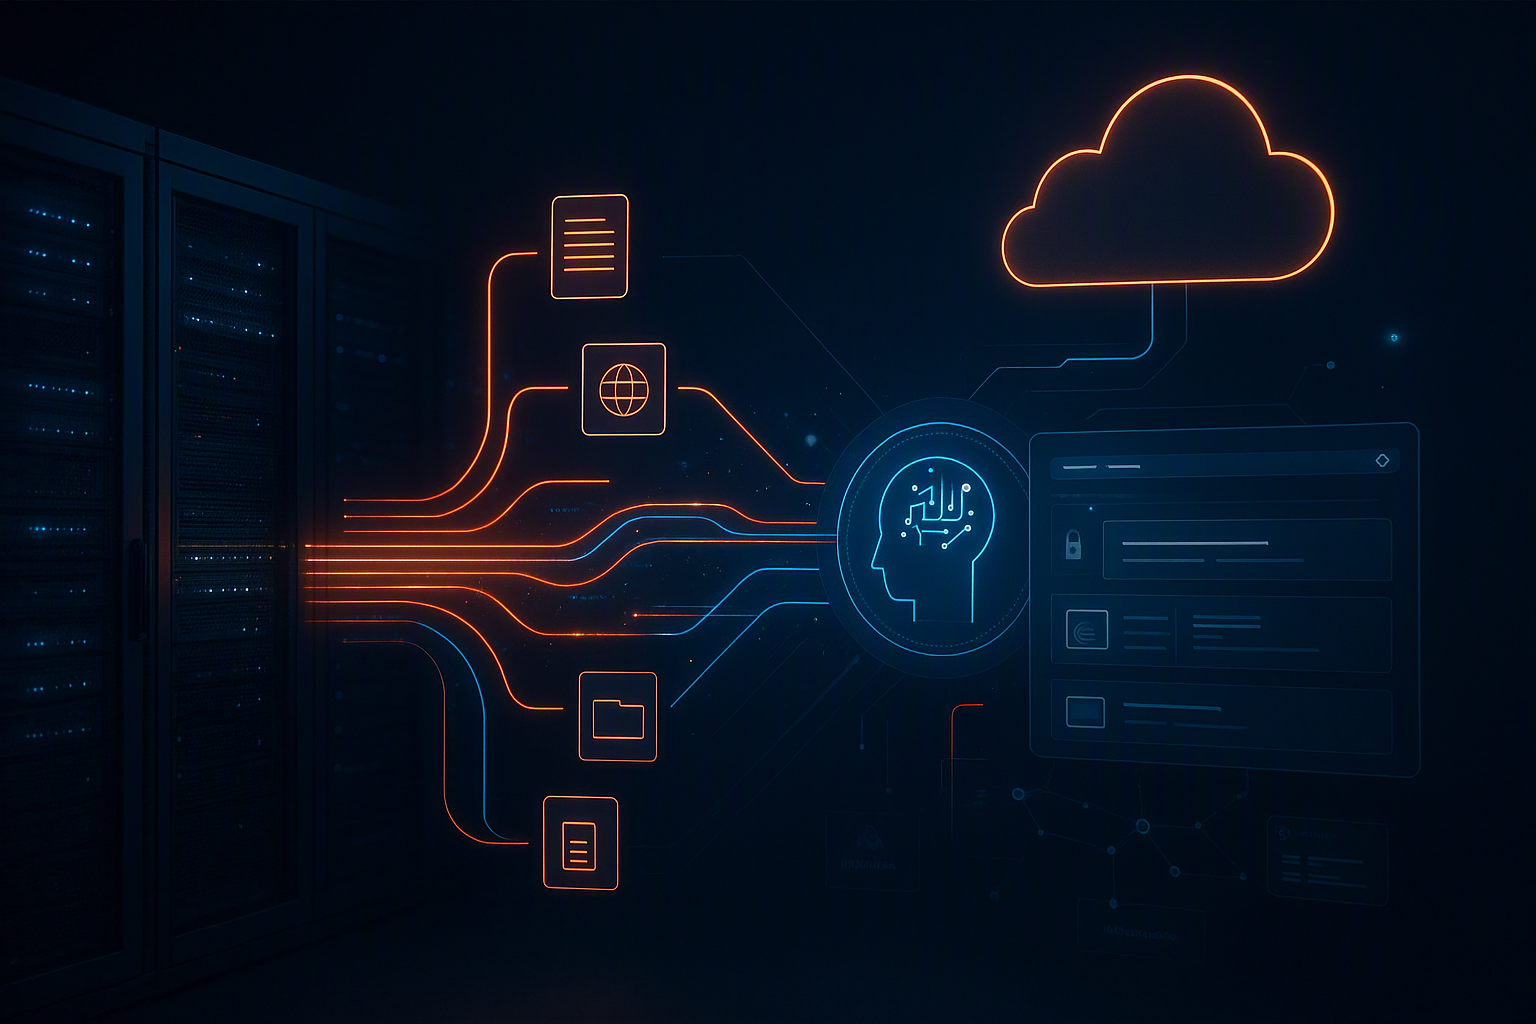
Cloudflare با توسعهی سرویس AI Search، مسیر ساخت موتور جستوجوی اختصاصی برای دادههای سازمانی را کوتاهتر کرده است. این سرویس اکنون میتواند وبسایتهایی را که نقشهی سایت کامل ندارند نیز با حالت «Discover» شناسایی و ایندکس کند، از چند منبع مختلف یک مخزن جستوجو بسازد و از طریق رابطهایی مانند /search و /mcp در اختیار برنامهها و عاملهای هوش مصنوعی قرار بگیرد.
این تغییرات، AI Search را از یک ابزار آزمایشی برای جستوجوی معنایی به زیرساختی آمادهتر برای کاربردهای واقعی نزدیک میکند.
اهمیت این خبر در آن است که توسعهدهندگان برای ساخت یک سیستم جستوجوی مناسب عاملهای هوش مصنوعی معمولاً باید چندین قطعهی جداگانه را به یکدیگر متصل کنند؛ از خزنده و پردازشگر محتوا گرفته تا مدل تولید embedding، پایگاه دادهی برداری، سامانهی رتبهبندی و رابط برنامهنویسی. Cloudflare میگوید AI Search این زنجیره را یکپارچه میکند تا دادههای ساختاریافته و غیرساختاریافته با پیچیدگی کمتر در اختیار برنامهها و agentها قرار بگیرند.
AI Search چیست و چه مشکلی را حل میکند؟
AI Search را میتوان یک زیرساخت مدیریتشده برای RAG یا «تولید تقویتشده با بازیابی اطلاعات» دانست. در این معماری، مدل زبانی بهجای آنکه صرفاً بر اساس دادههای آموزشی قدیمی پاسخ دهد، ابتدا اطلاعات مرتبط را از یک منبع مشخص پیدا میکند و سپس پاسخ را بر اساس همان اطلاعات تولید میکند.
برای مثال، یک شرکت میتواند مستندات فنی، راهنماهای داخلی، مقالات پشتیبانی یا فایلهای سازمانی خود را در AI Search ایندکس کند. عامل هوش مصنوعی هنگام دریافت پرسش، بخشهای مرتبط را بازیابی کرده و از آنها برای ارائهی پاسخی دقیقتر استفاده میکند. چنین رویکردی احتمال پاسخهای ساختگی را کاهش میدهد و بهویژه برای دادههایی که مرتب تغییر میکنند، کاربرد زیادی دارد.
Cloudflare پیشتر ابزارهایی مانند Workers AI برای اجرای مدلها، Vectorize برای جستوجوی برداری، R2 برای ذخیرهسازی، AI Gateway و Browser Run را بهصورت جداگانه ارائه میکرد. AI Search قرار است این اجزا را در یک مسیر کامل از دریافت داده تا بازیابی اطلاعات کنار هم قرار دهد.
نکتهی کلیدی این است که AI Search صرفاً یک کادر جستوجوی بهتر نیست؛ این سرویس میخواهد نقش لایهی بازیابی اطلاعات برای عاملهایی را ایفا کند که باید به دادههای بهروز و اختصاصی دسترسی داشته باشند.
پایان وابستگی کامل به Sitemap
یکی از تغییرات مهم نسخهی جدید، اضافهشدن حالت Discover برای خزیدن در وبسایتها است. پیش از این، وبسایت موردنظر باید نقشهی سایت یا Sitemap داشته باشد تا صفحات آن بهدرستی در AI Search قرار بگیرند. اکنون سرویس میتواند از نشانی آغازین وبسایت شروع کند، لینکهای موجود در صفحات را دنبال کند و در کنار Sitemap، محتوای کشفشده از طریق خزیدن را نیز جمعآوری کند.
این قابلیت برای وبسایتهایی اهمیت دارد که Sitemap ناقص دارند، ساختار محتوایی پیچیدهای دارند یا بهروزرسانیهای آنها همیشه در نقشهی سایت ثبت نمیشود. مدیران میتوانند برای فرایند کشف، عمق خزیدن و سقف صفحات قابل بررسی را تعیین کنند. در مستندات Cloudflare، نمونهای با محدودیت ۵۰۰۰ صفحه و عمق سه سطح ارائه شده است.
در نتیجه، راهاندازی یک نمونهی جستوجو میتواند با یک فرمان از طریق ابزار خط فرمان Wrangler انجام شود؛ فرمانی که مراحل خزیدن، دریافت محتوا، ساخت embedding و بازیابی اطلاعات را مدیریت میکند. این مدل راهاندازی، زمان لازم برای ساخت نمونهی اولیه را کاهش میدهد و نیاز به پیادهسازی دستی چندین سرویس را کمتر میکند.
جستوجو در چند منبع از طریق یک نقطهی دسترسی
قابلیت مهم دیگر، امکان جستوجو در چند نمونه یا Instance از طریق یک Endpoint واحد است. برای نمونه، یک شرکت میتواند مستندات فنی، پایگاه دانش خدمات مشتریان و محتوای وبسایت خود را در نمونههای جداگانه نگهداری کند، اما کاربران یا عاملهای هوش مصنوعی از یک مسیر مشترک به همهی آنها دسترسی داشته باشند.
در این ساختار، یک Namespace میتواند مسیرهایی مانند /search، /chat/completions و /mcp را در اختیار بگذارد. عامل یا برنامهی متصل، پرسش را به یک نقطه ارسال میکند و AI Search آن را در منابع انتخابشده بررسی میکند. چنین معماریای بهجای آنکه دادهها را بهصورت جزیرههای مستقل مدیریت کند، امکان جستوجو در یک مجموعهی یکپارچه را فراهم میکند.
این قابلیت برای پروژههایی که از MCP یا Model Context Protocol استفاده میکنند، اهمیت ویژهای دارد. MCP روشی استاندارد برای اتصال عاملهای هوش مصنوعی به ابزارها و منابع داده است. Cloudflare پیشنهاد میکند اتصال AI Search به برنامه یا سرور MCP از طریق یک Worker انجام شود، اما توسعهدهندگان میتوانند Endpointهای عمومی را نیز مستقیماً در اختیار کاربران یا سرویسهای دیگر قرار دهند.
دامنهی اختصاصی و کنترل دسترسی برای دادههای خصوصی
Cloudflare اکنون به کاربران اجازه میدهد Endpointهای عمومی AI Search را روی دامنهی اختصاصی خود قرار دهند. بهعنوان مثال، یک شرکت میتواند بهجای استفاده از نشانی تولیدشده توسط Cloudflare، سرویس جستوجوی خود را روی دامنهای مانند search.example.com ارائه کند. این کار علاوه بر ایجاد ظاهر حرفهایتر، مدیریت برند و تجربهی کاربری را نیز سادهتر میکند.
برای دادههای حساس، امکان استفاده از Cloudflare Access نیز وجود دارد. در این حالت، مدیران میتوانند دسترسی به Endpointهایی مانند /mcp را به عاملها یا کاربران مشخص محدود کنند. عاملهای نرمافزاری میتوانند با Service Token احراز هویت شوند و کاربران انسانی نیز از طریق ارائهدهندهی هویت سازمانی وارد شوند.
این قابلیت برای شرکتهایی که قصد دارند دستیار داخلی، سامانهی جستوجوی مستندات یا عامل پشتیبانی مشتری بسازند، مهم است؛ زیرا عمومیبودن Endpoint نباید به معنای عمومیبودن محتوای ایندکسشده باشد.
پشتیبانی از EmDash و کاربردهای واقعی Cloudflare
AI Search با سیستم مدیریت محتوای متنباز EmDash نیز یکپارچه میشود. وبسایتهایی که با EmDash ساخته شدهاند، میتوانند با استفاده از افزونهی AI Search، جستوجوی معنایی را روی محتوای خود فعال کنند. در جستوجوی معنایی، سیستم فقط به تطبیق کلمات کلیدی وابسته نیست و تلاش میکند مفهوم پرسش و ارتباط آن با محتوای صفحات را نیز درک کند.
Cloudflare اعلام کرده است که از AI Search در بخشهایی از اکوسیستم خود استفاده میکند؛ از جمله وبسایت Cloudflare، مستندات توسعهدهندگان و Cloudflare Dev Stack MCP. این نمونهی MCP به عاملهای کدنویسی اجازه میدهد مستندات فعلی و ارجاعپذیر Cloudflare را بازیابی کنند تا پاسخها بر اساس قابلیتها و اصلاحات جدیدتر شکل بگیرند، نه صرفاً دادههای قدیمی مدل زبانی.
مدل قیمتگذاری چگونه خواهد بود؟
Cloudflare اعلام کرده است که در دورهی بتا، AI Search بهصورت رایگان در دسترس است. پس از رسیدن سرویس به مرحلهی ارائهی عمومی، مدل قیمتگذاری جدید اجرا خواهد شد.
بر اساس توضیحات فعلی، هزینهی Embedding و Re-ranking هنگام استفاده از مدل پیشفرض یا برخی مدلهای منتخب در کاتالوگ Workers AI دریافت نمیشود. در مقابل، تولید پاسخ و بازنویسی پرسوجو بر اساس میزان استفاده از مدل محاسبه خواهد شد. این تفکیک میتواند هزینهها را برای تیمهای توسعه قابل پیشبینیتر کند، زیرا بخشهای ثابتتر فرایند جستوجو الزاماً با تعداد توکنهای مصرفی افزایش پیدا نمیکنند.
بااینحال، هزینهی نهایی برای هر پروژه به عواملی مانند حجم داده، تعداد دفعات خزیدن، میزان جستوجو، مدل مورد استفاده برای تولید پاسخ و تعداد کاربران یا عاملها بستگی خواهد داشت. بنابراین رایگانبودن دورهی بتا را نباید معادل رایگانبودن سرویس در زمان عرضهی عمومی دانست.
محدودیتها و نکاتی که توسعهدهندگان باید در نظر بگیرند
AI Search بخشی از کار دشوار ساخت سامانهی RAG را ساده میکند، اما تمام چالشها را از بین نمیبرد. کیفیت پاسخ همچنان به کیفیت دادههای منبع، ساختار صفحات، نحوهی قطعهبندی محتوا و انتخاب مدل بستگی دارد. اگر اطلاعات قدیمی، ناقص یا متناقض وارد ایندکس شوند، عامل هوش مصنوعی نیز ممکن است پاسخ نادرستی تولید کند.
از سوی دیگر، حالت Discover اگر بدون محدودیت مناسب استفاده شود، میتواند صفحات ناخواسته یا محتوای کمارزش را وارد ایندکس کند. تنظیم عمق خزیدن، سقف صفحات، فیلترهای متادیتا و سیاستهای دسترسی برای پروژههای بزرگ ضروری خواهد بود.
همچنین Endpoint عمومی برای دادههای خصوصی گزینهی مناسبی نیست، مگر آنکه با سازوکارهایی مانند Cloudflare Access محافظت شود. سازمانها باید پیش از اتصال AI Search به عاملها، سطح دسترسی هر عامل، امکان ثبت گزارش فعالیت و نحوهی حذف یا بهروزرسانی دادهها را مشخص کنند.
جمعبندی
بهروزرسانیهای مرداد ۱۴۰۵ برای Cloudflare AI Search، این سرویس را به گزینهای جدیتر برای ساخت موتور جستوجوی اختصاصی و زیرساخت RAG تبدیل میکند. حذف نیاز اجباری به Sitemap، جستوجو در چند منبع از یک Endpoint، پشتیبانی از MCP، امکان استفاده از دامنهی اختصاصی و کنترل دسترسی، مهمترین تغییراتی هستند که توسعهی عاملهای مبتنی بر دادههای اختصاصی را سادهتر میکنند.
اکنون باید دید Cloudflare در زمان عرضهی عمومی، چه مدلهای بیشتری را پشتیبانی میکند، قیمتگذاری نهایی چگونه خواهد بود و آیا این سرویس میتواند در پروژههای بزرگ سازمانی، دقت و مقیاسپذیری وعدهدادهشده را حفظ کند.